
AI-inference die in Ede blijft.
Open AI-modellen op GPU's in datacenter BIT-2C, bereikbaar via een OpenAI-compatibele API.
Je draait open modellen op kaarten in ons rack in Ede en spreekt ze aan zoals je nu een cloud-API aanspreekt. Het verschil zit in wat er niet gebeurt: we slaan je prompts niet op en trainen er niet op, vastgelegd in je contract, en de verwerking gebeurt alleen in Ede. Zet je eigen servers ernaast en je data hoeft het gebouw niet eens uit.
Elke prompt is een datatransfer.
Een AI-aanroep voelt als een functie-aanroep, maar het is een datatransfer. Elke prompt bevat wat je op dat moment aan het model laat zien: een klantdossier, een contract, een stuk broncode, de transcriptie van een gesprek. Bij een cloud-API gaat dat de deur uit naar een partij waarvan je de voorwaarden hebt geaccepteerd, maar de verwerking niet kunt controleren.
De misvatting is dat TLS dat oplost. TLS beschermt de weg, niet de bestemming. Wat er aan de andere kant met je prompt gebeurt, hoe lang hij bewaard blijft en onder welk recht, staat in een beleidsdocument dat je niet hebt onderhandeld. Bij ons staat het model in Ede en staan de afspraken in je eigen contract.
AI-inference bij ons past als je:
- Documenten, dossiers of broncode door een model wilt halen die je niet naar een cloud-API buiten de EU wilt sturen
- Een RAG- of documentpipeline bouwt en de vectordatabase liever naast het model zet dan erachter op internet
- Onder AVG, NIS2, BIO2 of DORA moet kunnen uitleggen waar verwerking plaatsvindt en wie erbij kan
- Al een OpenAI-compatibele integratie hebt en alleen de basis-URL wilt wijzigen
- Voorspelbare kosten wilt voor een vaste werklast, zonder per token te rekenen
Een endpoint, een rack, een contract.
Je krijgt een werkend endpoint en de afspraken eromheen. Geen console met honderd knoppen, wel een engineer die je spreekt.
Wat we niet leveren: frontier-modellen. Wel het juiste open model voor je taak, op hardware in Ede in plaats van in een wereldwijde wachtrij.
Het model in hetzelfde gebouw als je data.
Dit is de combinatie die we als één pakket leveren: colocatie in hetzelfde datacenter als de inference. Je servers, je vectordatabase en je applicatie staan naast het model, verbonden met een cross-connect of een privé-VRF op ons EVPN-netwerk.
- Elke prompt en elk document gaat over het publieke internet naar een endpoint dat je niet beheert
- Een API-sleutel die werkt vanaf elk adres op internet
- Egress-kosten en internetbandbreedte voor elke batch documenten
- Verwerking in een regio naar keuze van de leverancier, onder diens voorwaarden
- Model, vectordatabase en applicatie in hetzelfde gebouw; het verkeer gaat niet over het internet
- Geen publiek endpoint en geen API-sleutel op internet: het endpoint is alleen bereikbaar vanuit je eigen VRF
- Geen egress-kosten, bandbreedte op LAN-snelheid voor RAG- en documentpipelines
- Bereikbaar vanaf je andere locaties via ons eigen netwerk, of via internet met TLS of WireGuard
Hybride kan ook: basislast op je eigen GPU-servers in colocatie, piek via de gedeelde capaciteit, dezelfde API.
Het model laten kijken waar het probleem zit.
Via MCP, een open standaard voor gereedschap dat een AI-model mag gebruiken, kan het model in je eigen omgeving onderzoeken met jouw vraag als opdracht. Waarom flapt die VPN-tunnel, welke regel houdt dit verkeer tegen, welk apparaat trekt de lijn vol. Een FortiGate of een UniFi Dream Machine Pro koppelen is daarbij geen bijzonder werk.
- 01Alleen-lezenStandaard kijkt het model alleen
Configuratie, logs, sessies en statistieken. Een wijziging gebeurt alleen na goedkeuring van een mens, en alleen als dat vooraf is afgesproken.
- 02PrivéOver je eigen verbinding
Tussen het model en je omgeving kan alles over een cross-connect of privé-VRF lopen. Je firewall hoeft daarvoor geen beheerpoort op internet open te zetten.
- 03Beperkt accountJouw sleutel, jouw grens
Het model werkt met een eigen account met alleen-leesrechten op je apparatuur, dat je zelf intrekt. Wat er is opgevraagd en wanneer, leg je vast in je eigen logging.
- 04MaatwerkOok voor je eigen systemen
FortiGate en UniFi zijn voorbeelden. Heeft je apparatuur of software een API, dan bouwen we de koppeling er in overleg bij.
Een AI-model kan zich vergissen. Daarom onderzoekt en adviseert het, en beslist een mens.
Gedeeld naar verbruik, dedicated per maand.
Eén endpoint met een vaste modelselectie, je betaalt naar verbruik. Voor wie begint, test of een wisselende werklast heeft. Dezelfde afspraken over data en verwerking als bij dedicated.
Vaste kaarten alleen voor jou, met een vast maandbedrag. Je kiest het model, ook je eigen open gewichten als ze op de hardware passen. Niemand anders deelt je capaciteit, je latency of je wachtrij.
Het juiste open model voor je taak.
Kleine en middelgrote open modellen, tot ruwweg 30 miljard parameters per model; groter in overleg. Voor de meeste taken in een organisatie is dat ruim, en van elk model weet je wie het maakte en onder welke licentie je het gebruikt. Hieronder een voorbeeldselectie; het actuele aanbod stemmen we af.
Algemene assistent, tool calling
Apache 2.0Sterk in Nederlands
Gemma-gebruiksvoorwaardenSnel, redeneren
Apache 2.0Alle EU-talen, eenvoudige taal
Apache 2.0Embeddings voor RAG, meertalig
MITSpraak naar tekst
MITChinese taalmodellen, zoals Qwen, zetten we alleen op verzoek in, met een herkomstlabel, nooit standaard. Eigen open gewichten draaien op dedicated kaarten als ze passen. Welke modellen er op dit moment staan, stemmen we in de intake af.
Gemeten verbruik, geen schatting.
Op aanvraag krijg je een maandrapport met het gemeten stroomverbruik van je inference, toegerekend naar wat jij gebruikte, en de CO2 die daarbij hoort. Bruikbaar voor je VSME- of CSRD-rapportage onder scope 3.
- 01Stroom in kWh, gemeten
Het verbruik van de GPU's en de server zelf, uit de meting, niet uit een datasheet.
- 02Toegerekend naar jouw gebruik
Bij gedeeld naar je tokens, bij dedicated naar je kaarten. Je ziet wat jouw aandeel was, niet wat het rack deed.
- 03Aandeel van het datacenter
Koeling en verliezen via de PUE van onze hal, live gemeten door BIT, zodat het getal klopt met die maand en niet met een jaargemiddelde.
- 04CO2 volgens twee methodes
Locatie- en marktmethode, met bron en emissiefactor erbij. BIT neemt Nederlandse stroom uit zon en wind af, aangetoond met afgeboekte Garanties van Oorsprong.
Het rapport is optioneel en op aanvraag. We noemen de inference niet groen of klimaatneutraal; je krijgt de meting en de bronnen, en beoordeelt het zelf.
Van intake tot endpoint.
- IntakeWelke taak, welke data, hoeveel verkeer. Daaruit volgt een voorstel: gedeeld, dedicated of een combinatie, met het model dat we aanraden en waarom.
- Contract en addendumVerwerkersovereenkomst en het addendum over training en opslag. Pas als dat getekend is, komt er productiedata in de buurt van een kaart.
- Endpoint en toegangJe krijgt je endpoint: via internet met TLS, via WireGuard, of via een cross-connect of privé-VRF als je servers ernaast staan. De eerste aanroepen lopen we met je na.
- In gebruikJe ziet je verbruik, wij houden de modellen en de hardware bij. Updates gaan in een onderhoudsvenster dat we vooraf aankondigen.
Een model eerst proberen kan op de gedeelde capaciteit, met testdata, voordat je iets uit productie aansluit.
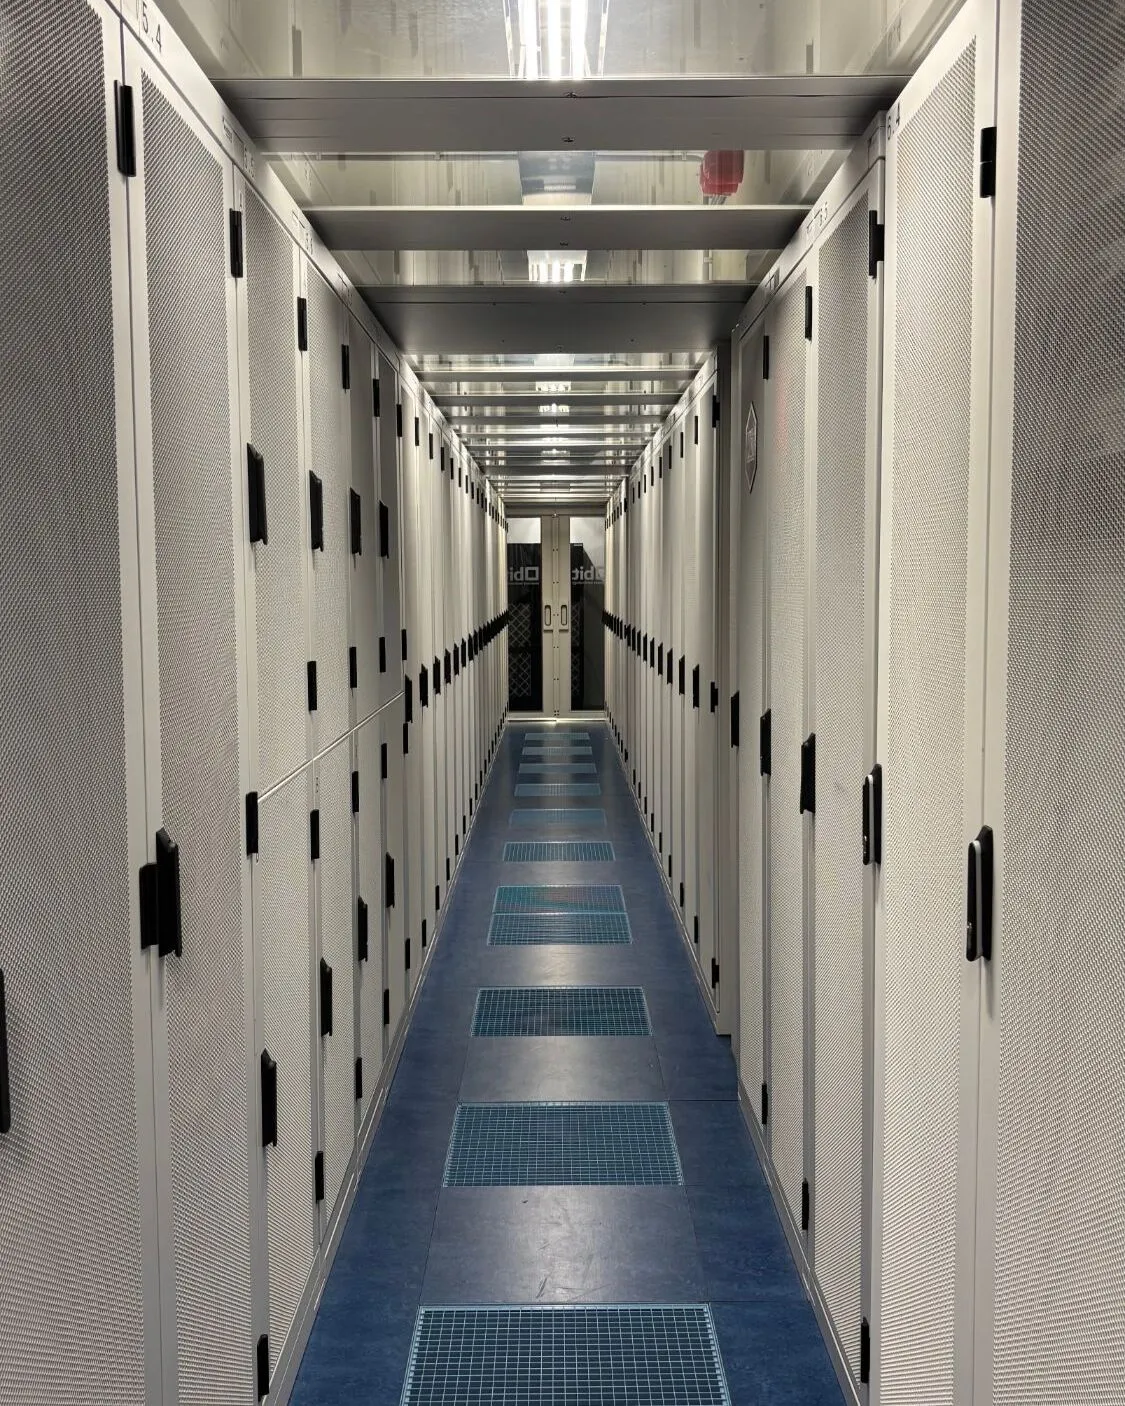
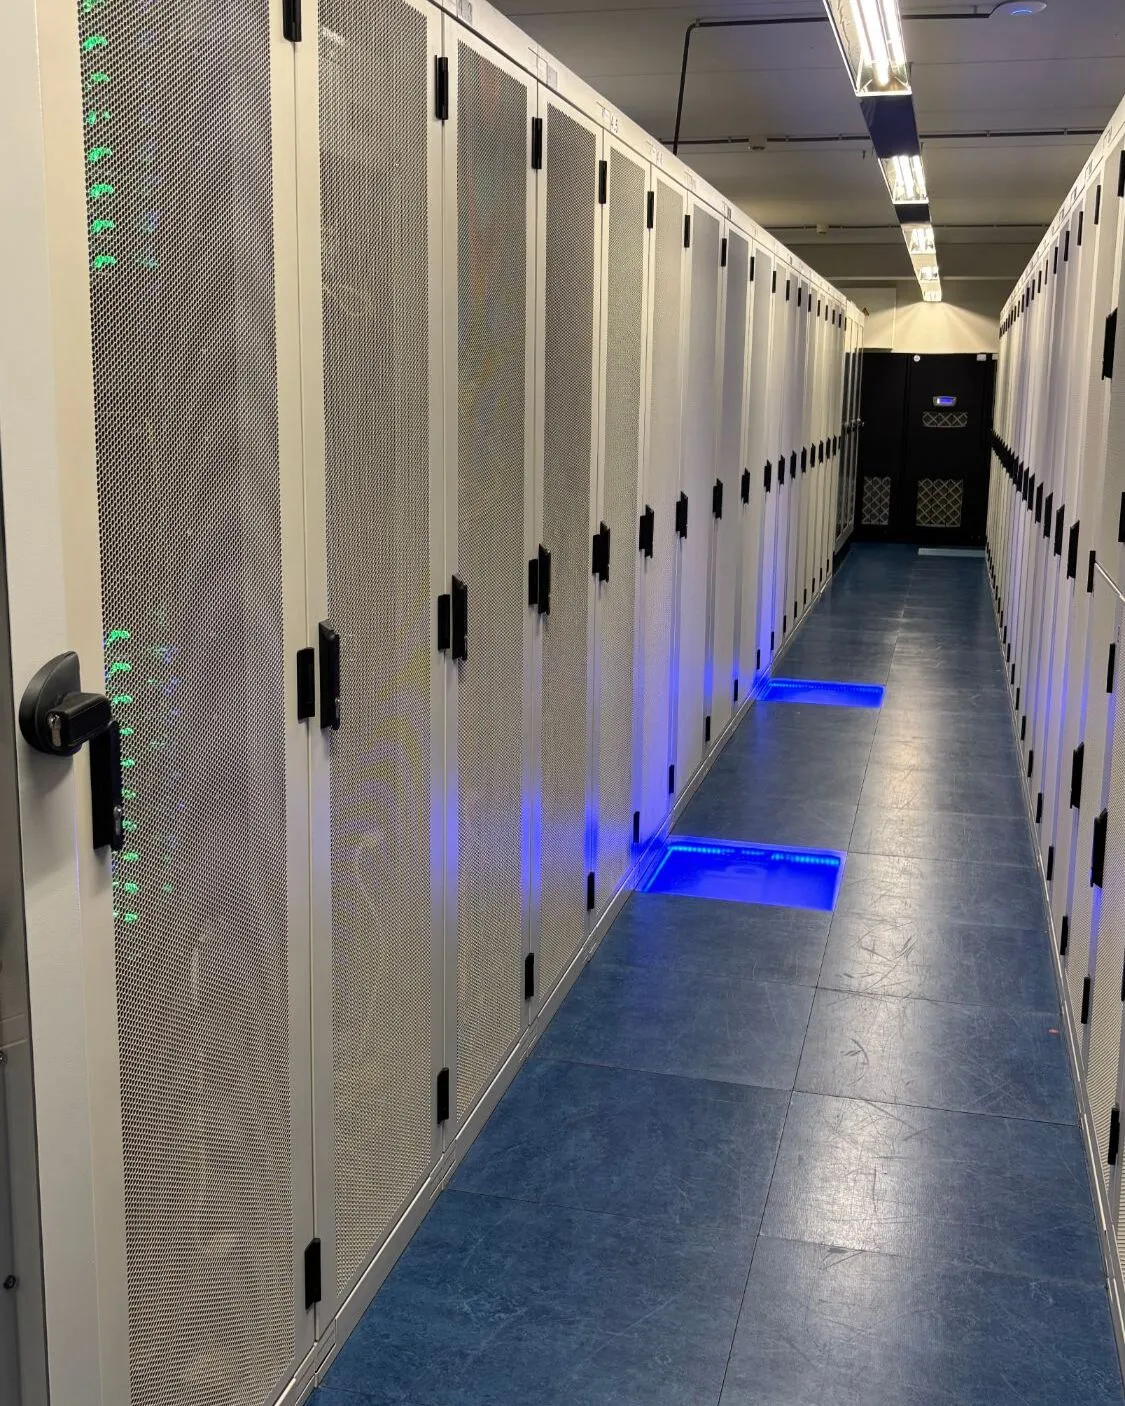
Netwerk, datacenter en model uit één hand.
- Eigen netwerk, AS211588, met corelocaties in NorthC en Nikhef en rackspace in alle BIT-datacenters in Ede
- Colocatie, cross-connects en privé-VRF's doen we dagelijks; het model is de nieuwe buurman in het rack
- Engineers die je direct spreekt, ook over kwantisatie, context en latency
- Afspraken over je data staan in het contract, niet op een beleidspagina
Geen prijsvechter. Wel de partij die het model, het netwerk en het rack eromheen begrijpt.
Veelgestelde vragen over AI-inference
Zijn deze modellen goed genoeg vergeleken met de grote cloudmodellen?
Voor veel taken in een organisatie wel: samenvatten, classificeren, extractie, vraag-en-antwoord over eigen documenten, transcriptie. Een model van 24 of 27 miljard parameters doet dat goed, zeker met RAG op je eigen bronnen. Voor open redeneren over alles en nog wat blijft een frontier-model sterker; dat leveren we niet. In de intake zeggen we eerlijk of je taak past.
Hoe zit het met de AVG en de verwerkersovereenkomst?
In de regel zijn wij verwerker en ben jij verwerkingsverantwoordelijke. De verwerkersovereenkomst legt vast dat verwerking alleen in Ede plaatsvindt, en het addendum dat we niet trainen op je data en je prompts niet opslaan. Dat helpt bij je verantwoording onder de AVG, NIS2, BIO2, DORA en de AI Act. Het maakt je er niet mee compliant; dat blijft je eigen werk.
Hoe stap ik over van de OpenAI-API?
Je wijzigt de basis-URL en de sleutel in je client en kiest een modelnaam uit onze selectie. Chat completions, embeddings en transcriptie werken via dezelfde paden. Prompts die op een groot model zijn afgestemd, wil je meestal even nalopen; daar kijken we in de eerste week naar.
Draaien jullie ook Chinese modellen?
Alleen op verzoek, met een herkomstlabel. Modellen zoals Qwen zijn technisch goed, maar we zetten ze nooit standaard in de gedeelde selectie. Wil je er een op dedicated kaarten, dan kan dat, en dan staat erbij waar hij vandaan komt.
Wat verbruikt dit aan energie?
Dat meten we. Op aanvraag krijg je een maandrapport met kWh, toegerekend naar jouw gebruik, het aandeel van het datacenter en de CO2 volgens locatie- en marktmethode, met bron en emissiefactor. Zonder groene labels: je krijgt de meting.
Wat als mijn model niet past?
Modellen tot ruwweg 30 miljard parameters passen op onze kaarten, vaak ook in een gekwantiseerde variant met weinig kwaliteitsverlies. Groter is in overleg: soms past het met kwantisatie, soms is het antwoord nee. Past het niet, dan zeggen we dat vooraf, niet na de eerste factuur.
Weten welk model bij je taak past?
Vertel ons wat je door het model wilt halen en hoeveel. Na een intake krijg je een voorstel met het model, de vorm en de afspraken over je data.